予測モデリングの基礎
このセクションでは、DataRobotの予測ソリューションについて説明します。予測モデルの構築手順に関する一般的な説明については、予測ワークフローの概要を参照してください。 生成AI関連のツールやオプションの操作の概要については、GenAIを使ってみるを参照してください。
予測AIでは、自動化された機械学習(AutoML)を使用して、あらゆる分野や業界における現実世界の問題を解決するモデルを構築します。 DataRobotは、教師あり学習、教師なし学習、時系列モデリング、セグメント化モデリング、マルチモーダルモデリングなど、MLモデリングへのさまざまなアプローチをサポートしています。 このセクションでは、これらのアプローチについて説明し、デプロイに最適なモデルを分析および選択するためのヒントも伝授します。
このセクションでは、予測モデリングの方法について説明します。 予測モデルの構築手順に関する一般的な説明については、ワークベンチでの予測モデルトレーニングの概要を参照してください。
予測モデリングの方法
MLモデリングとは、過去のデータの例で学習するアルゴリズムを開発するプロセスです。 これらのアルゴリズムは、結果を予測し、簡単に識別できないパターンを明らかにします。 DataRobotは、さまざまなモデリング方法をサポートしており、それぞれが特定のタイプのデータおよび問題タイプに適しています。
教師あり学習と教師なし学習
機械学習の最も基本的な形態は教師あり学習です。
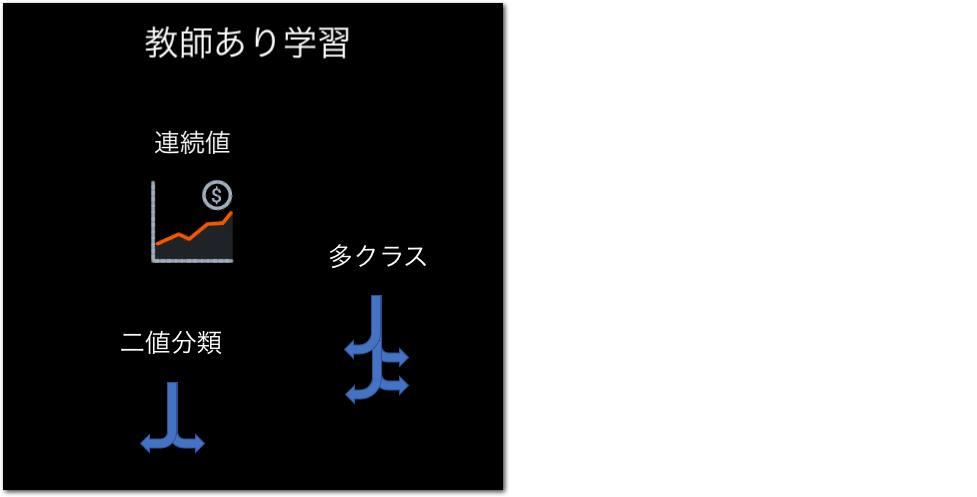
教師あり学習では、「ラベル付けされた」データを提供します。 データセット内のラベルは、アルゴリズムがデータから学習するのに役立つ情報を提供します。 ターゲットとも呼ばれるラベルは、予測対象としているものです。
-
連続値のエクスペリメントでは、ターゲットは数値です。 連続値モデルは、入力変数のリストが与えられた場合に連続的な従属変数を推定します(別名特徴量または列)。 連続値問題の例には、財務予測、時系列予測、メンテナンスのスケジューリング、および気象分析などがあります。 連続値エクスペリメントは、ターゲットタイプを数値から分類に変更することで、分類として扱うこともできます。
-
分類のエクスペリメントでは、ターゲットはカテゴリーです。 分類モデルは、特定のクラスの共通の特性を識別することにより、観測値をカテゴリーにグループ化します。 これらの特性を分類しているデータと比較し、観測値が特定のクラスに属する可能性を推定します。 分類エクスペリメントは二値(2つのクラス)または多クラス(3つ以上のクラス)に分けることができます。 分類については、DataRobotはターゲット特徴量に可変数のクラスまたはラベルがある多ラベルモデリングもサポートしています。データセットの各行は、単一、複数、またはゼロのラベルに関連付けられています。
機械学習のもう1つの形式は、教師なし学習です。
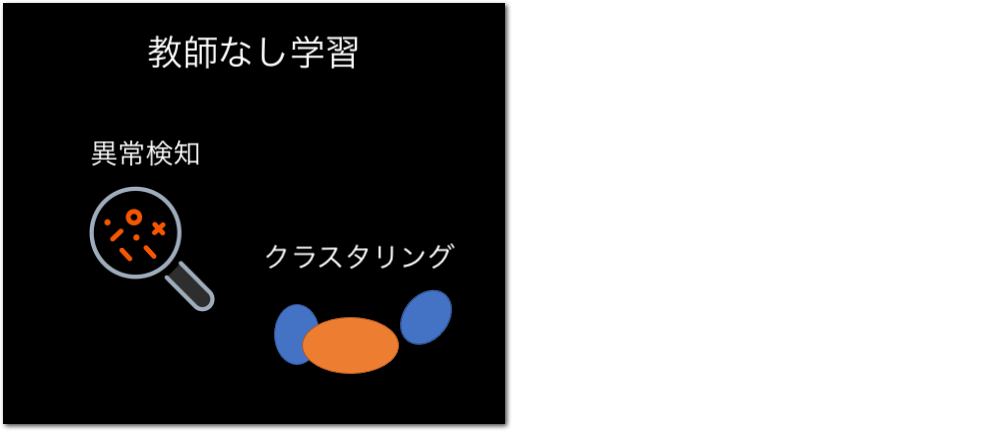
教師なし学習では、データセットにラベルが付けられておらず、アルゴリズムでデータのパターンを推測する必要があります。
-
異常検知エクスペリメントでは、アルゴリズムがデータセット内の異常なデータポイントを検出します。 ユースケースには、不正なトランザクションの検出、ハードウェアの障害、およびデータ入力中の人為的エラーが含まれます。
-
クラスタリングエクスペリメントでは、アルゴリズムはデータセットを類似性に応じてグループに分割します。 クラスタリングは、データの直感的理解に役立ちます。 クラスターは、データセットに教師あり学習方法を使用できるように、データのラベル付けにも役立ちます。
時間認識モデリング
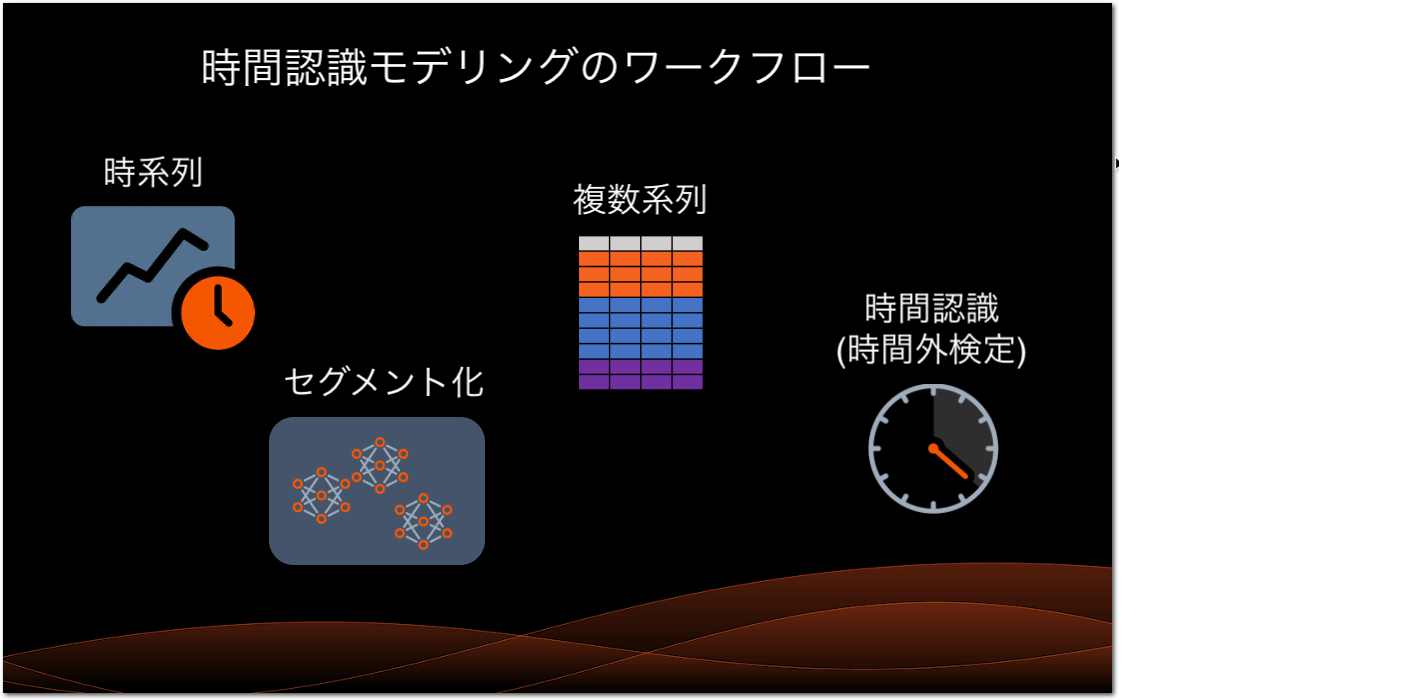
時間データは、予測問題を解決する上で重要な要素です。 時間に関連するデータを使用するモデルは、行単位の予測、時系列予測、または現在値の予測である「ナウキャスト」を作成します。 データが適切で、分割手法が日付/時刻に設定されている場合、エクスペリメントは時間認識になります。
-
時系列モデリングを使用して、将来の一定期間の一連の予測を生成できます。 過去のデータで時系列モデルをトレーニングして、将来のイベントを予測します。 将来の値の範囲を予測するか、ナウキャストを使用して現在の時点での予測を行います。 時系列モデリングのユースケースには、金融、医療、小売などの分野(基本的には、問題に時間的要素があるすべての分野)における価格設定と需要の予測が含まれます。
-
単一の系列を含むデータセットの時系列モデリングを使用できますが、複数系列を含むデータセットのモデルを構築することもできます。 このタイプの複数系列エクスペリメントでは、1つの特徴量が系列識別子として機能します。 例としては、データセットを場所ごとに1つずつ、複数系列に基本的に分割する「店舗の場所」識別子があります。 たとえば、4つの店舗所在地(パリ、ミラノ、ドバイ、東京)がある場合、モデリングには4つの系列が必要になります。
-
複数系列エクスペリメントでは、セグメント化されたモデリングを使用して各系列のモデル生成を選択できます。 この場合、DataRobotは各セグメントに最適なモデルを使用してデプロイを作成します。
-
解決しようとしている問題のデータセットに日付と時刻の情報が含まれている場合がありますが、時系列モデリングのように予測生成を行う代わりに、各行のターゲット値を予測します。 このアプローチは時間認識予測と呼ばれます。
これらの戦略の詳細については、時間認識モデリングとは?を参照してください。
特殊なモデリングワークフロー
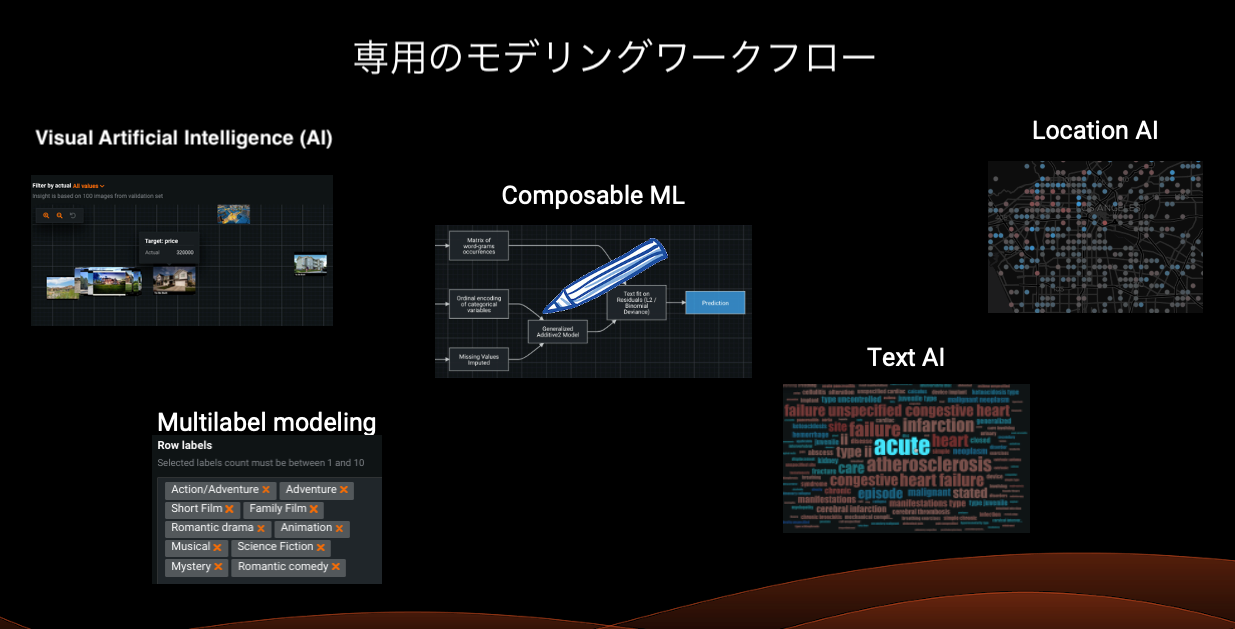
DataRobotは、さまざまな問題に対処するのに役立つ特殊なワークフローを用意しています。
-
画像オーグメンテーションを使用すると、データセットに画像を特徴量として含めることができます。 画像データを他のデータ型と一緒に使用して、連続値、分類、異常検知、クラスタリングなど、さまざまなタイプのモデリングエクスペリメントの結果を改善します。
-
編集可能なブループリントを使用すると、DataRobotの前処理とモデリングアルゴリズム、および独自のモデルを組み込んだMLブループリント(モデル構築に必要な前処理ステップ(タスク)、モデリングアルゴリズム、後処理ステップ)を自由に構築・編集することができます。
-
データ内のテキスト特徴量については、ワードクラウドのようなテキストAIのインサイトを使用して、そのインパクトを理解します。
-
Location AIはモデリングデータの地理空間分析をサポートします。 地理空間特徴量を使用すると、モデリングの前後にインタラクティブマップを使用してインサイトを取得しデータを視覚化できます。
ワークベンチでの予測モデルの構築手順に関する一般的な説明を参照してください。 あるいは、モデル構築の基本ステップでご自身で試してみてください。
使用例
DataRobotは、さまざまな業界の複雑なエンタープライズ環境を統合するように設計されました。 以下では、一部のDataRobotのお客様が予測AIをどのように活用しているかについて、その大まかな概要を説明します。 この概要には、2023年の実際の使用状況の統計が反映されています。
保険のユースケース
-
ある大手多国籍保険会社は、不正検知、保険金請求処理、引受審査など、さまざまなユースケースにおいて、全社的にDataRobotを活用しています。 モデル開発では、DataRobotプラットフォームで、エクスペリメント、モデルのテスト、および説明可能性チェックが、非常に積極的に行われています。 DataRobotを使用すると、これらのモデルをリスク管理プロセスでうまく活用でき、本番環境で多大な価値を実現できます。
概要
- エクスペリメント:1,000件を超えるプロジェクトと数万のモデルが構築されました。
- 実運用:数千のモデルがデプロイされ、DataRobot MLOpsによって管理されています。
- 予測:これまでに数億件、バッチおよびリアルタイムモードで月平均数千万件の予測が行われています。
-
ある多国籍保険会社は、EMEA地域および日本においてDataRobotを大規模に使用しています。 DataRobotは、顧客維持のユースケース、リードスコアリング、およびビジネス全体での引受プラクティスのカギとなります。
概要
- プロジェクト/エクスペリメント:750件以上(現在も増加中)、数万のモデルが構築されました。
- 本番環境のモデル:数千のモデルがデプロイされ、DataRobot MLOpsによって管理されています。
- 予測:10,000件を超える予測リクエストから、2億5000万件を超える予測行が生成されました。
-
ある大手再保険会社は、DataRobotがモデルの構築と予測の提供による摩擦を取り除く方法に感銘を受けています。 ユースケースには、未払い請求書の予測による延滞請求書回収の最適化および市場価格の予測が含まれ、競合他社が価格変更を実施した時期を判断するために、見積もりアグリゲータから見積もりを取得します。 DataRobotのマネージドSaaS製品を利用しているため、コンピューティングリソースの可用性について気にする必要がなく、代わりに数百人のユーザーに向けたデータサイエンスの成果に注力することができています。
概要
- プロジェクト/エクスペリメント:15,000件を超え、現在も増加中です。
- 構築された機械学習モデル:約20万個です。
- 予測:DataRobotの高性能予測サーバーで10億件以上処理されています。
ヘルスケアのユースケース
世界的な製薬大手は、DataRobotを使用してビジネス効率を向上させています。 DataRobotを使用して、以下の操作を行います。
- 北米およびEMEAでの需要予測
- 米国での購買傾向を予測
- ITチケットの予測
- コンテンツの推奨を実行します。
製造分野のユースケース
-
世界最大級の建材メーカーの1社が、予知保全のためにDataRobotを活用しています。 モデルは、重要な生産設備の故障を予測します。 予知保全モデルは、さまざまなユースケースの中でも、重要な生産ラインの予期せぬ停止を回避し、経済的損失を最小限に抑えるのに役立っています。
チームは、DataRobot上でモデルの構築、再トレーニング、管理を行っています。 その後、モデルはDataRobotのポータブル予測方法の1つであるスコアリングコードとして、工場現場のエッジデバイスにデプロイされます。 スコアリングコードは、DataRobotの予測サーバーを呼び出すことなく、設備の近くでローカルに実行されます。 各工場には、設備のタイプごとに専用のモデルパッケージが提供されます。
概要
- ユースケース:重要な生産設備の予知保全。
- デプロイ:数十の工場にまたがるエッジデバイス上のスコアリングコード。
- モデリング:DataRobotを使用して、工場および設備のタイプごとに個別にトレーニングを行います。
- ライフサイクル:モデルはDataRobotから積極的に保守、再トレーニング、再デプロイが行われます。
小売分野のユースケース
-
ある運送会社がDataRobotを活用して、複数部門のプラットフォーム上に170人以上のアクティブユーザーを抱え、輸送、サプライチェーン、運送事業を支援しています。 DataRobotを使用して、着信の予測と人員計画の改善、宅配センターでの盗難の可能性の予測、特定の国への荷物の総量の予測、および財務KPIの予測を行います。 彼らは、DataRobot上で構築されたエクスペリメントとモデルが、プラットフォーム外で構築された予測モデルよりも優れていることを目の当たりにしています。 主要なユースケースで、50%以上のエラー削減が行われています。 精度が向上したことで、月単位から週単位、さらには日単位の予測へと、きめ細かな内訳での予測が可能になりました。
-
欧州最大のメディア企業の1社は、2018年からDataRobotを利用しています。彼らは、デプロイされたモデルを使用して、需要の最適化、ターゲットを絞った広告、およびコンテンツ管理を行っています。 最近では、オーディエンスのセグメンテーションと広告のターゲット化のための大規模なバッチ予測をサポートするために、予測環境を拡張しました。 チームは、DataRobot/Snowflakeの連携機能を活用して、計算負荷の高い予測パイプラインを維持し、毎週のスコアリングを期限内に完了しています。 DataRobotを使用すると、小規模なデータサイエンスチームは高い精度でより効率的な作業が可能となり、以前よりも迅速にモデルを稼働させ、最適化された在庫管理によって増分収益の増加を達成できます。