派生した特徴量
特徴量探索プロセスでは、さまざまなヒューリスティックを使用して、DataRobotプロジェクトで派生する特徴量のリストが決定されます。 結果は、検出された特徴量タイプ、特徴量の特性、データセット間の関係性、データサイズの制約など、多くの要因に応じて異なります。
特徴量エンジニアリングのコントロールと 特徴量削減のセクションも参照してください。
派生した特徴量の分析
EDA2が完了した後、データページには新しく発見され、派生した特徴量が、プロジェクトデータタブに対応する有用性スコアと共に表示されます。

派生したすべての特徴量が一覧表示されるようになりました。 名前は、データセットのエイリアスと変換のタイプで構成されます。 (詳細は、集計リファレンスを参照してください。) 表示が連結された場合は、特徴量にカーソルを合わせて完全な名前を表示できます。

データページで使用できる一部のタブは、特徴量探索を使用しないプロジェクトと同じように機能します。
特徴量探索プロジェクトの分析に役立ち、データタブで使用できる追加のタブとツールが提供されます。
特徴量の系統
プロジェクトデータタブで特徴量にアクセスすると、特徴量の系統タブが利用可能になります。 プロジェクトデータタブには、使用可能なすべてのプロジェクト特徴量(元の特徴量、ユーザー変換または自動変換された特徴量、および特徴量探索プロセスによって派生した特徴量)のリストが表示されます。 特徴量をクリックして展開し、その特性を調べます。 特徴量では、種類に応じてさまざまなサブタブがあり、その内の1つは特徴量の系統タブです。
特徴量の系統タブには、特徴量がどのように派生したかを示す視覚的な説明および特徴量の派生プロセスで使用されたデータセットが表示されます。 ここでは、元のデータセット(左側)から特徴量(右側)を生成するために使用された手順が可視化されます。 各要素は、1つのアクションまたはJOINを表します。
特徴量をクリックして展開し、特徴量の系統タブをクリックします。 例:

結果では、次のような操作ができます。
-
変換前には、プライマリーデータセットとセカンダリーデータセットが表示されます。 セカンダリーデータセットの名前をクリックすると、情報ページがAIカタログに表示されます。
-
情報(
i)アイコンにマウスオーバーすると、要素の詳細が表示されます。 -
可視化の要素をクリックすると系統が表示されます。 親アクションは、クリックした要素の左側にあります。 特徴量を1回クリックすると、その親特徴量が表示されます。再度クリックすると完全な表示に戻ります。

これに対し、黄色のCustomerIDをクリックすると、JOINと結果としての派生した特徴量が示されます。

-
白い三角形は、この特徴量に対して次のアクション(最大、カウントなど)が実行されることを示します。

-
時計アイコンでマークされた要素(
 )は時間を認識します(時間インデックスを使用して派生します)。
特徴量探索タブ
データページの特徴量探索タブは、データセットの関係性の詳細、特徴量の派生のサマリー、特徴量の派生ログを提供します。
データ関係性の詳細
特徴量探索タブは、データセットの関係性を可視化します。 タブは、セカンダリーデータセットの数、探索された特徴量、および特徴量探索の結果となる派生した特徴量を表示します。

データセットの詳細については、データセットのタイルのメニューにある詳細をクリックします。
特徴量派生サマリー
プライマリーデータセット全体の特徴量を生成する前に、DataRobotはデータセットのサンプルを評価して、以下の項目の識別と破棄を行います。
- インパクトの少ない特徴量
- 冗長な特徴量

特徴量探索 タブで 詳細表示をクリックすると、特徴量の探索に使用される特徴量エンジニアリングのコントロールが表示されます。
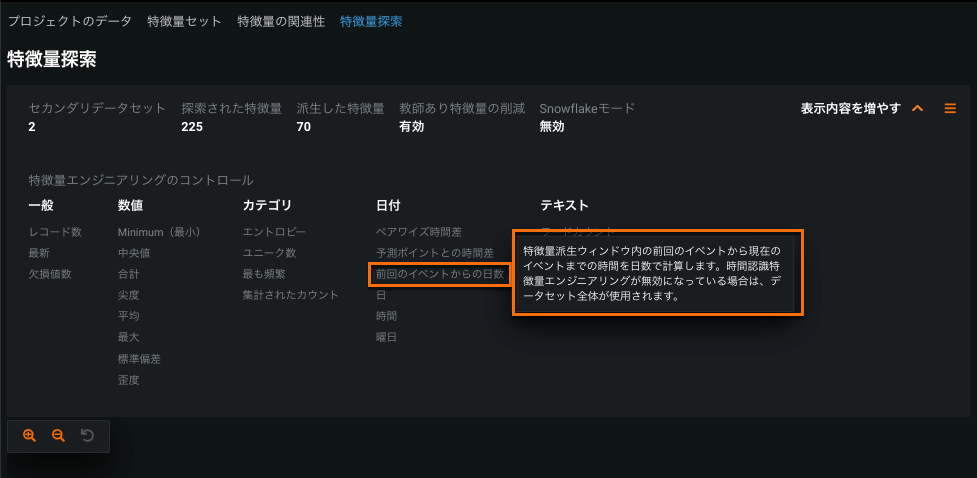
上記の例では、200の特徴量が評価(探索)され、132は特徴量削減プロセスで削除された結果であり、データセットに68の派生した特徴量が発生します。 DataRobotは、68の派生した特徴量を有用な特徴量の特徴量セットに自動的に追加します。
右のメニューで データセットのダウンロードオプションをクリックすると、特徴量探索プロセスにより生成されたデータセットをダウンロードします。つまり、セカンダリーデータセットから派生した多くの新しい特徴量です。

ダウンロードしたCSVには、元のデータセットおよび特徴量探索によって派生した特徴量が含まれます。破棄された特徴量および相互作用を検索オプションによって検索された特徴量は含まれません。
特徴量派生ログ
特徴量の生成および削減のプロセスの詳細については、右のメニューで特徴量派生ログオプションをクリックします。

特徴量派生ログは、次のことを示します。
- テーブル間の関係性
- 各セカンダリーデータセットで処理される特徴量の数
- 削除された特徴量と削除の理由

データセット内の特徴量の数によっては、ログにすべてのアクティビティが表示されず、プレビューが表示される場合があります。完全なログコンテンツにアクセスします。 ダウンロードをクリックすると、完全なログコンテンツにアクセスします。
特徴量の集約
DataRobotが特徴量の派生プロセスの一部として新しい特徴量を作成する場合、以下に説明されるように、特徴量の名前は、特徴量に対して行われたアクションを示しています。
-
プライマリーテーブル:特徴量の名前は、この特徴量の名前から始まります。 プライマリーテーブルの名前は含まれません。 これは、予測ポイントとして使用される日付特徴量に適用されます。
-
セカンダリーテーブル:テーブル名はプライマリーテーブルの特徴量の名前に追加され、括弧内
[ ]に示されたセカンダリー特徴量の名前が含まれます。 適用された特徴量エンジニアリングは、丸括弧( )内に追加されます。 -
変換:自動変換またはユーザー変換した特徴量は、情報アイコン(
 )から始まります。

検出された特徴量タイプに基づいて適用される集約の一覧を以下の表に示します。 この例では、サンプルの顧客/販売データセットが使用されています。
備考
特徴量探索中に、特定の特徴量タイプの変換を有効および無効にできます。 詳細については、特徴量エンジニアリングの管理を参照してください。
一般的な特徴量タイプ
| 集約 | 例 |
|---|---|
| レコード数 | 各顧客の取引数 |
| 中間エンティティごとの最小数 | 各顧客のすべての注文における注文あたりの最小項目数 |
| 中間エンティティあたりの最大数 | 各顧客のすべての注文における注文あたりの最大項目数 |
| 中間エンティティごとの平均数 | 各顧客のすべての注文における注文あたりの平均項目数 |
| 最新 | 各顧客が購入した最新の製品 |
数値特徴量タイプ
| 集約 | 例 |
|---|---|
| 最小 | 顧客あたりの最小取引金額 |
| 最大 | 顧客あたりの最大取引金額 |
| 合計 | 顧客ごとのすべての取引の合計金額 |
| 平均 | 顧客のすべての注文における注文あたりの平均項目数 |
| 中央値 | 顧客のすべての注文における注文あたりの項目数の中央値 |
| 欠損値数 | 欠損している顧客ごとの取引数 |
| 標準偏差(一連の値の変動を測定します) | 顧客ごとの注文における商品価格の標準 |
| 歪度(度数分布曲線の非対称性を示す尺度) | 顧客注文における品目価格の分布の、平均に対する非対称性 |
| 尖度(正規分布に対する分布の裾の重みを示す尺度) | 顧客注文における品目価格の分布の「裾」 |
カテゴリー特徴量タイプ
| 集約 | 例 |
|---|---|
| 最も頻繁 | 顧客ごとの取引で最も多い小売店タイプ |
| エントロピー | 顧客ごとの取引における小売店タイプのエントロピー |
| 集計されたカウント | 各顧客の小売店タイプごとの取引数 |
| ユニーク数 | 各顧客の固有の小売店タイプの数 |
| 欠損値数 | 小売店タイプが欠損している取引数(顧客あたり) |
日付特徴量タイプ
| 集約 | 例 |
|---|---|
| 前回からの間隔 | 同じ顧客による最後の取引からの時間(取引ごと) |
| 最後からの時間 | 顧客の最後の取引の決算日からの時間 |
| 作成日からの期間 | プロファイル作成日における顧客の年齢 |
| 日付差のエントロピー | 決算日のあるビニング済み差分のエントロピー |
| ペア単位の日付差 | セカンダリーデータセット内のペア単位のデータの差分(最大10の異なる日付列) |
テキスト特徴量タイプ
| 集約 | 例 |
|---|---|
| 単語/文字数 | 備考の長さ |
| 集計されたトークン数 | すべての取引の製品説明の各単語/文字の数 |
カテゴリー統計
数値の特徴量は、合計、最小、最大、カウント、平均などの一般的な統計によって集計できますが、これらの統計グループを他のカテゴリの列値で集計する方が理にかなっている場合もあります。
次のビジネスユースケースでは、製品タイプによる平均支出が支出の全体の平均額よりも便利です。 Spending 支出数値特徴量の値は、製品タイプのカテゴリー特微量のカテゴリーに対応します。

特徴量探索でカテゴリー統計値の集計が有効になっている場合、DataRobotは製品タイプ特徴量の各カテゴリーの数値統計を探索します。例:
- Spending(最小30日)
- Spending(Product_タイプ = Aで最小30日)
- Spending(Product_タイプ = Bで最小30日)
- Spending(Product_タイプ = Cで最小30日)
- ...

カテゴリー別統計の集計はデフォルトで無効化されています。 有効にする方法については、特徴量エンジニアリングの管理を参照してください。
備考
特徴量探索は、最大で50個のユニーク数な値があるカテゴリー列のカテゴリー統計値のみを探索します。