モデルをAWS EKSにデプロイする
DataRobot MLOpsでは、DataRobotモデルを社内のAWS Elastic Kubernetes Service(EKS)クラスターにデプロイできますが、MLOpsの監視およびガバナンス機能も引き続き利用できます。
このエクスポート可能なDataRobotモデルは、ポータブル予測サーバー(PPS)と呼ばれています。 このモデルはDockerコンテナに組み込まれるため、柔軟性と移植性があり、Kubernetesなどのコンテナオーケストレーションツールに適しています。
次の手順で、DataRobotモデルをEKSにデプロイする方法を説明します。
開始する前に
本機能の提供について
DataRobotモデルをEKSにデプロイするには、「MMMモデルパッケージのエクスポートを有効化」フラグを必要とするモデルパッケージをエクスポートする必要があります。 この機能を有効にする方法については、DataRobotの担当者にお問い合わせください。
Amazon EKSにデプロイする前に、EKSクラスターを作成する必要があります。 クラスターをスピンアップするには、次の2つの方法があります。
-
eksctlツール(Amazon EKSのCLI)を使用。 これは、EKSクラスターを作成する最も簡単で最速の方法です。
-
AWSマネジメントコンソールを使用。 この手法では、きめ細かいチューニング(IAMロールやVPCの作成など)が可能です。
このトピックでは、eksctlツールを使用したインストール方法を紹介します。 詳細な手順については、Amazon EKSの開始方法 – eksctlを参照してください。
いずれかのツールがすでにインストールおよび設定されている場合は、対応する手順をスキップできます。
AWSおよびEKSのインストールと設定
以下で説明する手順に従って、Amazon Web Services CLI、EKS、およびKubernetes CLIをインストールして設定します。
-
AWS CLI(バージョン2)をインストールします。
aws --version -
AWS CLIの認証情報を設定します。
-
eksctlをインストールします。
eksctl version -
kubectl(KubernetesクラスターのCLI)をインストールして設定します。
kubectl version --short --client
モデルをEKSにデプロイする
DataRobotモデルをKubernetesインフラストラクチャにデプロイすることは、主に次の3つのアクティビティで構成されます。
- MLOpsパッケージを含むDockerコンテナを準備し、コンテナレジストリにプッシュする
- DataRobotで外部デプロイを作成する
- Kubernetesクラスターを作成する
PPS Dockerイメージを設定して実行する
次の手順を完了するには、まずモデルを生成し、MLOpsモデルパッケージを作成します。
DataRobotは、ポータブル予測サーバーの設定とDockerイメージの作成に役立つUIを提供します。 次の手順を実行します。
- ポータブル予測サーバー(PPS)を設定します。
- PPS Dockerイメージを取得します。
- Dockerにイメージをロードします。
- モデルパッケージをダウンロードします。
- Dockerイメージを実行します。
- モデルを監視します。
- 外部デプロイを作成します。 デプロイの作成時は、MLOpsモデルIDとMLOpsデプロイIDをメモしておいてください。 MLOpsパッケージをKubernetesにデプロイするときに、これらのIDが必要になります。
Amazon ECRにDockerイメージをプッシュする
Amazon EKSクラスターがコンテナイメージをダウンロードして実行できるように、コンテナイメージをAmazon Elastic Container Registry(ECR)にアップロードする必要があります。
-
Elastic Container Registryに対して認証するようにDocker CLIツールを設定します。
aws ecr get-login-password --region us-east-1 | docker login --username XXX --password-stdin 00000000000.xxx.ecr.us-east-1.amazonaws.com -
ビルドしたばかりのDockerイメージをECRにプッシュします。
docker push 00000000000.xxx.ecr.us-east-1.amazonaws.com/house-regression-model:latest
Amazon EKSクラスターの作成
DockerイメージがECRに保存され、外部デプロイが作成されたので、Amazon EKSクラスターをスピンアップできます。 EKSクラスターには、次のいずれかを備えたVPCが必要です。
- 2つのパブリックサブネットと2つのプライベートサブネット
- 3つのパブリックサブネットを持つVPC
Amazon EKSでは、少なくとも2つのアベイラビリティーゾーンにサブネットが必要です。 パブリックサブネットとプライベートサブネットを持つVPCをお勧めします。Kubernetesがパブリックサブネットにパブリックロードバランサーを作成して、プライベートサブネット内のノードで実行されるポッドへのトラフィックを制御できるようにします。
Amazon EKSクラスターを作成するには、以下の手順を実行します。
-
(オプション)VPCに2つのパブリックサブネットと2つのプライベートサブネットを作成または選択します。 パブリックサブネットに対して「パブリックIPv4アドレスの自動割り当て」が有効になっていることを確認します。
備考
対応する
--vpc-private-subnetsおよび--vpc-public-subnetsパラメーターを指定しない場合、eksctlツールは必要なすべてのサブネットをバックグラウンドで作成します。 -
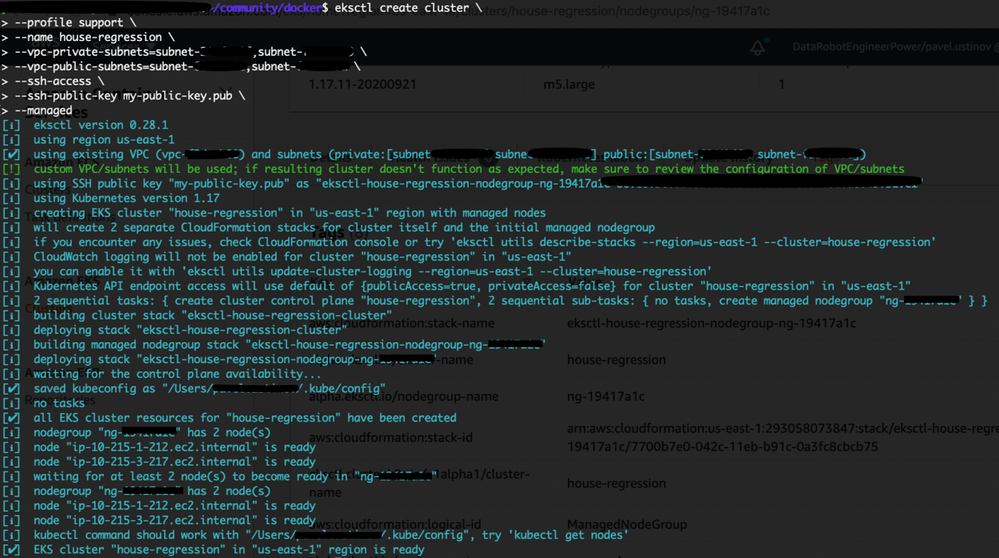
クラスターを作成します。
eksctl create cluster \
--name house-regression \
--ssh-access \
--ssh-public-key my-public-key.pub \
--managed
備考
-
--managedパラメーターを使用すると、Amazon EKSマネージド型ノードグループが有効になります。 この機能は、Amazon EKS Kubernetesクラスターのノード(EC2インスタンス)のプロビジョニングとライフサイクル管理を自動化します。 クラスター用に最適化されたノードグループをプロビジョニングできます。 EKSは、最新バージョンのKubernetesとホストOSでノードを最新の状態に保ちます。 eksctlツールでは、コマンドラインフラグまたは設定ファイルを使用して、特定のサイズとインスタンスタイプファミリーを選択できます。 -
--ssh-public-keyはオプションですが、クラスターでノードグループを作成するときに指定することを強くお勧めします。 このオプションは、マネージド型ノードグループ内のノードへのSSHアクセスを有効にします。 SSHアクセスを有効にすると、インスタンスに接続して、問題がある場合に診断情報を収集できます。 ノードグループの作成後にリモートアクセスを有効にすることはできません。
クラスターのプロビジョニングには通常10~15分かかり、結果は次のようになります。
-
-
クラスターの準備ができたら、kubectlの設定が正しいかどうかテストします。
kubectl get svc
MLOpsパッケージをKubernetesにデプロイする
MLOpsパッケージをKubernetesにデプロイするには、以下の手順を実行します。
-
次のように、Kubernetesの名前空間を作成します。
kubectl create namespace house-regression-namespace -
以下の内容をローカルマシンの
yamlファイル(この場合はhouse-regression-service.yaml)に保存し、プロジェクトの値に置き換えます。 画像、DataRobot APIトークン、モデルID、デプロイIDの値を指定します。 (MLOpsで外部デプロイを作成したときに、IDを保存しておく必要があります。)apiVersion: v1 kind: Service metadata: name: house-regression-service namespace: house-regression-namespace labels: app: house-regression-app spec: selector: app: house-regression-app ports: - protocol: TCP port: 80 targetPort: 8080 --- apiVersion: apps/v1 kind: Deployment metadata: name: house-regression-deployment namespace: house-regression-namespace labels: app: house-regression-app spec: replicas: 3 selector: matchLabels: app: house-regression-app template: metadata: labels: app: house-regression-app spec: affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: beta.kubernetes.io/arch operator: In values: - amd64 containers: - name: house-regression-model image: <your_aws_account_endpoint>.ecr.us-east-1.amazonaws.com/house-regression-model:latest env: - name: PORTABLE_PREDICTION_API_WORKERS_NUMBER value: "2" - name: PORTABLE_PREDICTION_API_MONITORING_ACTIVE value: "True" - name: PORTABLE_PREDICTION_API_MONITORING_SETTINGS value: spooler_type=filesystem;directory=/tmp;max_files=50;file_max_size=10240000;model_id=<your mlops_model_id_obtained_at_step_5>;deployment_id=<your mlops_deployment_id_obtained_at_step_5> - name: MONITORING_AGENT value: "True" - name: MONITORING_AGENT_DATAROBOT_APP_URL value: https://app.datarobot.com/ - name: MONITORING_AGENT_DATAROBOT_APP_TOKEN value: <your_datarobot_api_token> ports: - containerPort: 80 -
Kubernetesサービスとデプロイを作成します。
kubectl apply -f house-regression-service.yaml -
名前空間に存在するすべてのリソースを表示します。
kubectl get all -n house-regression-namespace
水平ポッド自動スケーリングの設定
Kubernetes Horizontal Pod Autoscalerは、デプロイ、レプリケーションコントローラー、またはレプリカセット内のポッド数を、そのリソースのCPU使用率に基づいて自動的にスケーリングします。 これにより、需要の増加に合わせてアプリケーションをスケールアップしたり、リソースが不要になったときにスケールバックしたりできるため、他のアプリケーション用にノードを解放できます。 目標のCPU使用率を設定すると、Horizontal Pod Autoscalerはアプリケーションをスケールアップまたはスケールバックして、その目標を達成しようとします。
-
php-apacheデプロイ用のHorizontal Pod Autoscalerリソースを作成します。
kubectl autoscale deployment house-regression-deployment -n house-regression-namespace --cpu-percent=80 --min=1 --max=5 -
名前空間に存在するすべてのリソースを表示します。
kubectl get all -n house-regression-namespaceHorizontal Pod Autoscalerがリソースリストに表示されます。

モデルを世界に公開する(ロードバランシング)
Amazon EKSは、LoadBalancerタイプのKubernetesサービスを介して、Amazon EC2インスタンスノードで実行されているポッドのNetwork Load BalancerとClassic Load Balancerをサポートします。
-
各アベイラビリティーゾーンでパブリックサブネットを(サブネットIDの辞書式順序で)選択する代わりに、VPC内のパブリックサブネットにタグを付けて、外部ロードバランサーにこれらのサブネットのみを使用することをKubernetesが認識できるようにします。
kubernetes.io/role/elb = 1 -
次の方法でプライベートサブネットにタグを付けて、内部ロードバランサーにサブネットを使用できることを、Kubernetesが認識できるようにします。
kubernetes.io/role/internal-elb = 1重要
2020年3月26日以降は、Amazon EKS AWS CloudFormationテンプレートを使用してVPCを作成する場合、テンプレートによって作成されたサブネットは、ここで説明されているように作成時にタグ付けされます。
-
kubectl
exposeコマンドを使用して、デプロイ用のKubernetesサービスを生成します。kubectl expose deployment house-regression-deployment -n house-regression-namespace --name=house-regression-external --type=LoadBalancer --port 80 --target-port 8080--portはロードバランサーで設定されたポート番号です。--target-portはデプロイコンテナがリッスンしているポート番号です。
-
次のコマンドを実行して、サービスの詳細を取得します。
kubectl get service -n house-regression-namespace
-
EXTERNAL_IPアドレスをコピーします。 -
EXTERNAL_IPアドレスを使用してモデルをスコアリングします。curl -X POST http://<EXTERNAL_IP>/predictions -H "Content-Type: text/csv" --data-binary @kaggle_house_test_dataset.csv
-
作成した外部デプロイのサービス正常性を確認します。 スコアリングリクエストが統計に含まれるようになりました。

削除
-
サンプルサービス、デプロイ、ポッド、名前空間を削除します。
kubectl delete namespace house-regression-namespace -
クラスターを削除します。
eksctl delete cluster --name house-regression
まとめ
この基本ステップでは、ポータブル予測サーバー(PPS)を介してAmazon EKSプラットフォームにDataRobotモデルをデプロイし、監視する方法について説明しました。 PPSはMLOpsエージェントと共にDockerコンテナに組み込まれているため、主要なIT(サービスの正常性、リクエスト数など)および機械学習(精度、データドリフトなど)指標をクラウドで取得し、一元化されたDataRobot MLOpsダッシュボードでそれらを監視できます。
DataRobot PPSを使用すると、ベンダーロックインを回避し、クラウド環境間で簡単に移行したり、複数の環境に同時にモデルをデプロイしたりできます。